[ITIL] CMDB模型设计1 [ZT FROM VSHARING BY 破子人生]
学习资料: ITIL先锋论坛专家讲堂直播 300期视频回放
ZT FROM:xqscool/A1274634.html
作者:破子人生 这几年以来,CMDB的模型每隔段时间在脑子里就会折腾一番,近期有一点小小突破,一直没有时间跟心情沉下来记录,到现在我仍然认为目前的CMDB的产品层的设计与实施层的建模思想都存在问题,可惜没有资源去验证自已的整个想法,我设计的模型如果有任何个人或公司在此之上做产品实现,我都是乐意的,甚至可以考虑提供免费的咨询支持,一个想法不断冲击你的大脑,你却无法看到它的实现与验证,这实在是一件让人沮丧的事情。 将这篇文章的标题写成CMDB模型设计仅仅是为了符合大家的认知与兴趣,我对CMDB这个狭义的名称越来越不感冒了,因为它与一个完整的ITSM系统有着某种二元对立之嫌,同时它又让大家忘记CMS是什么,所以接下来我讲的模型其实有两个层面,一个是基于CI级的模型,一个基于服务的模型,前者面对服务对象,后者面向服务本身,如果这两个模型是稳健的,它将一个ITSM的系统架构做了最底层的约束,或者说形成了这个ITSM系统的骨架或灵魂,基于这两个模型可以做许多延伸与分析,就我个人而言,我觉得它有一定的突破意义,对于外界或行业方面,只能在未来观察了。 首先要介绍的CI本身的构建模型,见下图
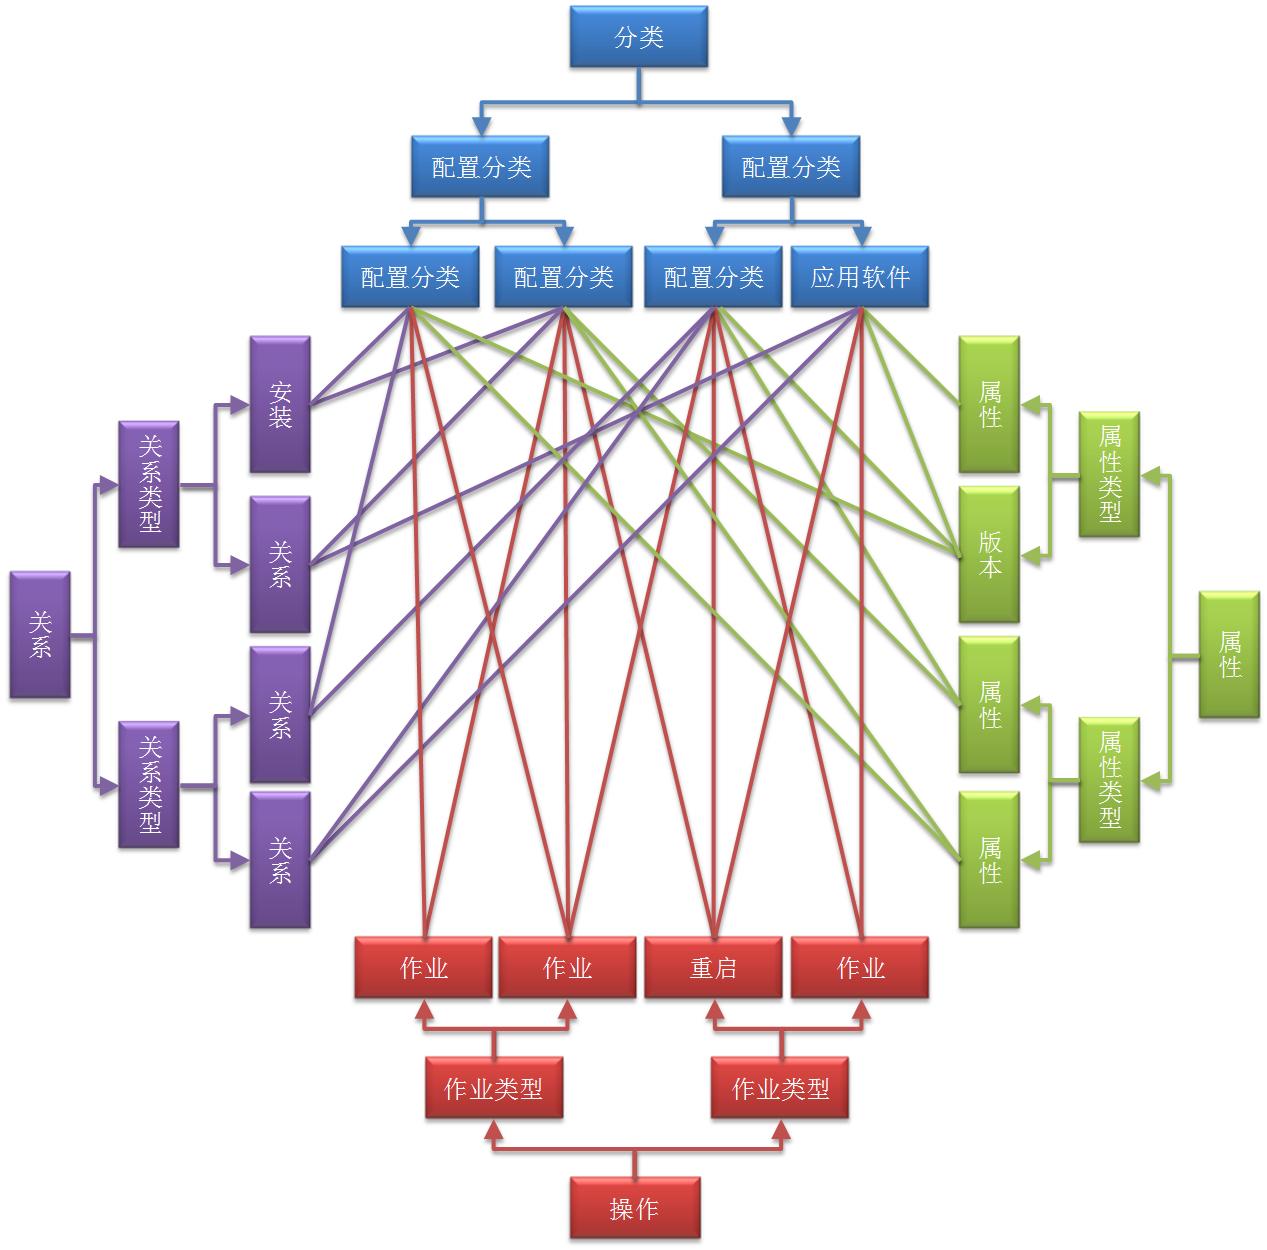
与面向对象的思想一样,用类的方式来构建CI,一个类有三个方面的特性,它与其它的类有什么样的关系,它有哪一些属性,它可以有哪一些动作,首先类、关系、属性、动作都需要结构化,且不能强制做分层数,即你不能要求CI分类全部要三层,你也不能要求关系只能做一层,这样等于形成四个树状的结构,以类为中心连接点,它可以与其它三个树形中的任何节点发生关系,拥有一个节点,则拥有其所有子节点,这会极大的灵活日后的维护,,下面分别讲解一下这几个纬度的意义:
1.分类: 即把IT架构中所有的元素进行分类别名。在这一个数据集中,只记录存着分类本身的树形结构,或者说是所有服务对象的分类结构,所以此处是不会出现虚拟CI的概念的,即类似组织、人员、地点、服务这类信息是不会成为某一种分类的,所以在这个模型之中,是建立IT架构本身的投影,尽可能真实的表达出真实架构的情况,在分类方面可以利用现有的资产清单,并做一次所有部门的服务对象调查,这样汇总后,做一次分析整理,做到完全穷尽,相互独立。理论上,如果两个分类它的关系、属性、动作全部一样,则不需要分成两个类,但在实施时我发现,不要吝啬分类的设计,许多人觉得属性一样时,就合并类,比如将刀片、PC服务器、小型机都置成一个类,叫服务器,这其实并不合适,因为问题是出在了属性设计上,而不出在类上,你不能因为A病了,让B去吃药。类能在、模型表达、动作、关系、统计分析上带无可比拟的方便性,它可以让你的一切都只需要基于类级做控制即可,如果只是在类上加一个属性叫“服务器类型”,这样的结果是你的系统功能变得非常复杂,你可能需要实现根据属性去过滤你的模型,需要考虑属性去计算业务影响,以及你的所有的报表统计。类的数据是整个CMDB的基础的基础,一定要严格做公司级的评审,当我们定清楚所有类的属性、关系、动作、生命周期时(注生命周期需要根据类去做不同的定义设计),事实上,我们就定义了变更的最小范围。为了让最终模型美观,可以根据类来设置不同的图例图片,来代表这个类,这样在模型时就可以显示依赖这个图片来表达显示。
2.关系: 在以前我一直希望抽象最精简的关系类型出来,慢慢的我感觉到这个路是不太可行的,可能有更简洁的方法去作业,我们在帮助一个客户实现CMDB时,我们可能根本不需要去提前帮客户抽象有哪几种关系类型,原因很简单,当我们定义出所有的类后,只要我们做一件事情,问问每一个类与其它所有的类会有怎样的关系,当我们把这个数据调查到之后,就会得到一个CMDB的蓝图,这个蓝图就是这个公司自已的CMDB模型,这样当在构建CI时,根本不需要用户再去决定填哪一种关系,因为关系是由类决定的,不是由CI决定的,当用户知道这个CI跟哪一个CI有关系时,模型层会自动添加上正确的关系类型,每个类跟哪一些类有怎样的关系,不能跟哪一些类有哪一些关系就在系统层做了控制,也就是说用户永远无法构建出错误的模型,他只能构建出错误的数据,每一个关系的数据,最后在实体CI填充时,类似属性一样,可以填写一个值,这个值即是“关系说明”,我们以前在模型层只画一根线,表达两者有一种连接关系,这种表达有时是不够的,尤其在应用程序之间的关系上,比如你在模型上看两个应用程序有依赖关系,当你鼠标停留在此关系上时,系统会调用关系说明的值,显示出“A程序需要每隔1小时调取B程序的库存数据”。类与类之间的关系蓝图是比较花气力一件事,同时它又非常重要,同样需要公司级的严格评审,一旦通过后,CMDB的模型就稳固了。关系的数据越细,日后的影响分析计算与模型表达就越精准,CMDB在实施时,以往存在的一个问题是,我们代替太多业务部门做太多的思考与决定了,当我们清楚每一个类时,每一个类与其它类有怎样的关系,其实业务部门最清楚,可以用一个很简单的调查表就实现盘点与收集,然后汇总评审,我发现这项工作太少人做了,其实只需要有几家公司认真去做一次,就完全可以总结出一个整个IT行业的关系蓝图,此时就可以做产品数据预制了。为了最终模型的美观,还可以定义不同的关系类型的线条粗细、颜色、箭头方向。
3.属性: 属性与以前的CMDB设计基本类似,不同之处在于,属性需要实现结构化,结构化的好处在于更加容易实现与类的关系建构,当一个类有一个属性子集(节点)时,自动拥有其下所有的属性,日后这个子集增加属性时,与它有关系的所有的类会自动增加此属性,同时更加容易让别人理解一个类的属性信息情况,单一的平面直列出数十个属性,会让人抓不住重点,以前如果要实现同性质的属性集中显示又需要进行界面定制开发,这成了一个两难的局面,一个简单些的逻辑是,将属性进行结构化,每一个节点形成一个单独的标签页,一个CI分类有几个节点就有几个标签页,同时每个标签页的属性显示可以做排序设定,这样可以达到既无须定制开发,又可以实现属性有效显示的效果。属性的填写方式需要进行控制,它如果是由用户选择,则需要定义它的数据源,比如地点信息,或者状态,如果是手工输入,则需要提供填写示例或说明的栏位,如果数值型,则需要考虑提供单位的选取等等。
4.动作: 一个类,或者说一个配置项,可能有怎样的维护或操作动作,这事实上属于服务标准化的过程,这也是目前整个IT服务行业最滞后的地方,每一名IT服务人员到底会做哪一些动作,每一种设备对应的维护动作有哪一些,最终每一种维护动作需要做多少次,需要多少时间成本,这对服务分析与服务管理是非常有意义的,它甚至可以解决能力成长与技能提升的问题,如果足够标准化,最后每一类设备的每一种动作形成一个手册,一个人是否能维护这一类设备,取决于他是否掌握这段上设备存在的所有动作,如果将一个设备的动作分解决了不同层次,那么一线与二线及三线的职能切分也就清楚了,因为大家的动作范围不一样,这又会带来派单处理的便利性,一个服务的内容有多少,事实上是由这个服务有多少个对象,这个对象有多少动作来决定的,这才是真正的服务目录。全年下来时,整个IT组织知道了每一种动作的平均时长是多少,全年操作次数是多少,哪一些人做哪一些动作是最多的,可以想象这种层面的分析,完全可以让我们的管理水平与分析水平发生质的改变。如果日后人类的作业行为更加标准化,这个模型还可以发展,因为动作与关系与属性其实存在关联,理论层面则言,一个属性的改变或一个关系的改变,一定是由于某个动作所导致的,这又会直接引生成新的变更控制思想,更疯狂的是,任何对象的事件与变更是可预见的,如果抽象出来后,我们还会发现,某一种现象的事件或某一种类型的变更,它一定会由某一种动作来实现完成,此时自动判断用什么动作来处理事件或变更就成为了可能,但这一步,估计目前是做不到的,需要做全方面的提高后,才能可能成为现实。 在产品设计时,需要把基础数据维护与基础数据间的关系设置一分为二,以方便独立作业,所以这里应该会产生7个功能点,必须可能由最终用户来实现CMDB的基础数据维护与发展,需要依赖开发力量来增加类与属性或关系,这是一种僵化的系统设计。以上说的这些都还只是CMDB的基础数据,或者说是CI的基础数据,真正的CI此时还没有出现,在下图中CI实例的模型。